Por que computadores só entendem 0s e 1s?
Do sistema binário ao Unicode: como míseros 0s e 1s viram números, textos, imagens e vídeos, e por que essa história começa muito antes dos computadores.
Certamente você já ouviu a expressão "por baixo dos panos computadores só entendem 0s e 1s", ou então lembra daquela imagem de 0s e 1s pra cima e pra baixo do filme Matrix. Mas como é que míseros 0s e 1s podem ser organizados de tal forma a gerar os textos que você lê no Twitter, as imagens que você curte no Instagram, e mais incrível ainda, esse vídeo do Vida em 8 Bits, com aúdio e tudo? Pra entender isso precisamos falar sobre representação de informação. A melhor maneira de representar qualquer tipo de dado é com números, pensa comigo, se eu quero representar um texto, posso definir que cada número representa uma letra, aí o A pode ser representado pelo 0, o B pelo 1, o C pelo 2, e assim por diante.
Sistemas de numeração
Estamos acostumados a manipular números utilizando 10 símbolos, com os algarismos de 0 a 9, e isso não é por acaso, começamos a contar coisas utilizando nossos 10 dedos. Tanto que a palavra dígito vem do Latim digitus que significa dedo. Nos primórdios não havia nenhum sistema de numeração, os registros eram feitos com desenhos, com o passar tempo se percebeu que o trabalho de desenhar a mesma coisa inúmeras vezes era perda de tempo, bastava desenhar a coisa 1 vez e representar a quantidade com riscos, mas aí alguém percebeu que tinha um jeito ainda mais fácil e assim nasceram os primeiros sistemas de numeração. De todos os sistemas primitivos, o único que ainda é de uso comum é o sistema de números romanos, vemos em datas, numeração de Papas, páginas de livros e horas no relógio. Subtrair e adicionar números romanos é razoavelmente simples, basta juntar tudo, mas multiplicação e divisão é bem complicado. O sistema numérico que utilizamos hoje em dia é o indo-arábico, que diferentemente dos antigos é um sistema posicional - um mesmo dígito dependendo da posição que ocupa no número equivale a um valor diferente. Vamos supor que você ganha R$ 2900, seria muito bom trocar o 9 e o 2 de lugar, mas você certamente não ficaria muito feliz em mexer os 0s de lugar. Aproveitando esse assunto, imagine que você recebeu como tarefa escrever um programinha pra somar dois números, x e y. Normalmente esses valores vão vir como texto, antes de somar é necessário converter de texto pra número, mas como resolvemos isso? Como o sistema decimal é posicional, cada posição tem um significado, na primeira posição temos a quantidade de unidades, na segunda a quantidade de dezenas, na terceira a quantidade de centenas e assim por diante. Por exemplo, considere o número 248, temos 2 centenas + 4 dezenas + 8 unidades.
Embora esse sistema seja extremamente conveniente pro nosso uso no dia-a-dia, não é muito eficiente pra representar informações, por exemplo, com uma mão você consegue representar os números de 0 a 5. Mas e se eu te disser que apenas mudando a forma como interpretamos os números, com os mesmos 5 dedos conseguimos representar até o número 31, olha só, vamos dizer que isso representa 1, isso representa 2, 3, até que isso representa 31.
Outras bases
Pra entender como isso é possível temos que falar de uma característica muito importante presente no sistema decimal, note que pra representar o 10 não temos nenhum símbolo especial, utilizamos 2 símbolos existentes, o 1 e o 0. Mas imagine que tívessemos apenas 4 dedos em cada mão, contaríamos 1, 2, 3, 4, 5, 6, 7, … e aqui esgotamos nossos símbolos, teríamos que recorrer novamente ao 10. E esse é o sistema octal:
| Decimal | Octal | Decimal | Octal |
|---|---|---|---|
| 0 | 0 | 9 | 11 |
| 1 | 1 | 10 | 12 |
| 2 | 2 | 11 | 13 |
| 3 | 3 | 12 | 14 |
| 4 | 4 | 13 | 15 |
| 5 | 5 | 14 | 16 |
| 6 | 6 | 15 | 17 |
| 7 | 7 | 16 | 20 |
| 8 | 10 |
O sistema binário
Agora sabemos que é possível definir múltiplos sistemas de numeração com bases diferentes, mas vamos logo pro que nos interessa, o mais extremo e ao mesmo tempo o mais simples de todos, aquele que tem apenas 2 símbolos, o 0 e o 1, o sistema binário. É fácil perceber que esse é o sistema numérico mais simples possível, pois se removermos o 1, ficamos apenas com o 0 e já não conseguimos mais representar nada. Ou seja esse 0 ou 1 representa a menor quantidade possível de informação, e isso tem um nome, um bit, um bit de informação. Nesse sistema os símbolos acabam muito rapidamente: 0, 1 e fim. Qual é a sequência lógica? Sim, o 10. A partir daqui seguimos a mesma lógica dos demais sistemas, no decimal, incrementamos o número menos significativo até que temos símbolos à disposição, 10, 11, 12, até o 19. No binário a lógica é a mesma, podemos ir de 10 para 11, e novamente já esgotamos as possibilidades para os 2 dígitos, pode não parecer à primeira vista, mas a exata mesma coisa acontece no sistema decimal. Quando chegamos no número 99 qual é o próximo número? 100. No sistema binário é exatamente a mesma coisa, 10, 11 e 100.
| Decimal | Binário | Decimal | Binário |
|---|---|---|---|
| 0 | 0 | 8 | 1000 |
| 1 | 1 | 9 | 1001 |
| 2 | 10 | 10 | 1010 |
| 3 | 11 | 11 | 1011 |
| 4 | 100 | 12 | 1100 |
| 5 | 101 | 13 | 1101 |
| 6 | 110 | 14 | 1110 |
| 7 | 111 | 15 | 1111 |
Pra entender na prática vamos trabalhar a conversão de algum número de binário pra decimal e vice-versa. Vamos pegar o número 12 como exemplo, sua representação binária é 1100. Pra converter de binário pra decimal usamos potências de 2 e multiplicamos o resultado pelo dígito correspondente, começamos a sequência de potência de 2 a partir do dígito menos significativo, então partindo da esquerda temos 2^0, 2^1, 2^2 e 2^3. Pra cada número da sequência multiplicamos o resultado pelo dígito correspondente, os dígitos com valor zero ignoramos pois qualquer coisa multiplicada por 0 retorna 0. Por fim basta somar os resultados parciais pra obter o número convertido pra decimal:
1 1 0 0
8 4      = 12
Perceba que apenas deslocando um bit à esquerda dobramos o valor: 100 é 4 e 1000 é 8. Isso faz sentido pois 100 é o mesmo que 2^2, enquanto que 1000 é o mesmo que 2^3. Fica fácil de perceber também que pra dividir um número por 2 basta fazer o inverso, deslocar um bit à direita.
Agora falta entender como fazer o caminho inverso, como obter a representação binária de um número decimal. Pra isso basta aplicarmos sucessivas divisões por 2 (anotando os restos, essa parte é muito importante) até reduzir o número a 0:
12 / 2 = 6, resto 0
6 / 2 = 3, resto 0
3 / 2 = 1, resto 1
1 / 2 = 0, resto 1
Agora pegamos os restos de baixo pra cima pra obter a representação binária: 1100.
Códigos binários antes dos computadores
Pra demonstrar a importância do sistema binário na história da computação vou pegar emprestado alguns trechos do excelente livro Code, de Charles Petzold - fica aqui a recomendação de leitura.
Imagine que você é uma criança da década de 90 e passou o dia inteiro com seus amigos fazendo coisas incríveis: andou de bicicleta, raspou o joelho, rapou bolinhas de gude de alguns de seus amigos, perdeu alguns tazos pra outros, trocou figurinhas pra preencher seu álbum - sim, a década de 90 foi incrível. Mas eis que chega a hora mais temida do dia, sua mãe diz que é hora de entrar. Seu melhor amigo mora em frente à sua casa, e na hora de dormir vocês querem conversar sobre todas as aventuras do dia. O MSN normalmente não é uma opção, a internet é discada e nesse horário a linha telefônica normalmente está ocupada pelos seus pais. O que você e seu amigo têm são lanternas, e começam a pensar em maneiras de trocar mensagens utilizando a luz das lanternas pela janela. A primeira ideia é literalmente desenhar as letras, mas obviamente não funciona, faz sentido pra quem está enviando, mas quem está do outro lado não entende absolutamente nada. Então vocês criam um sistema mapeando cada letra pra um número de piscadas da lanterna:
  A: 1
  B: 2
  ...
  Z: 26
Pra separar as letras vocês fazem uma pausa pra que quem esteja vendo consiga entender que uma letra foi enviada e que o envio da próxima começará em breve. Agora vocês conseguem enviar uma mensagem, mas não de forma eficiente, um simples oi como vai demandaria 102 piscadas. Isso se dá porquê esse sistema tem um único tipo de sinal. O código Morse por exemplo, usa dois tipos de sinais, um ponto e um traço, que com a lanterna poderia ser substituído por uma piscada rápida para o ponto, e uma piscada longa para o traço. Com isso a frase oi como vai poderia ser transmitida com apenas 25 piscadas - uma melhora e tanto.
O código Morse foi inventado em 1837 por Samuel Finley Breese Morse e melhorado por Alfred Vail. Permite a codificação de 30 símbolos - todas as letras do alfabeto latino mais algumas com acentuação. A definição dos símbolos não seguiu uma ordem lógica pra facilitar a memorização, ao invés disso, o objetivo foi otimizar o envio das mensagens - letras mais comuns possuem os menores códigos. Por exemplo, as letras E e T possuem os códigos 1 ponto e 1 traço. Esse é o primeiro de 4 grupos de códigos. Cada grupo contém todos os símbolos do grupo anterior com um ponto e um traço adicionado ao final de cada símbolo. Ao olharmos para o número de pontos e traços em cada grupo vemos emergir uma característica fundamental de todo sistema binário: uma sequência em potência de 2.
Antes de Samuel Morse criar seu código, outro código binário já havia sido inventado. Louis Braille, nascido na França, ficou cego tragicamente aos 3 anos de idade ao brincar com uma ferramenta pontiaguda na oficina de seu pai, o ferimento irradiou uma infecção para seu outro olho, deixando-o completamente cego. A impossibilidade de ler livros impressos naquela época era um obstáculo imenso na educação de crianças cegas, mas isso não impediu Louis, dos 12 aos 15 anos ele desenvolveu o código Braille inspirado em um sistema criado por Charles Barbier, um capitão do exército Francês, esse sistema consistia de pontos em relevo pra transmitir informações durante a noite quando era necessário fazer silêncio. O código Braille utiliza seis pontos pra representar cada símbolo, cada ponto pode ou não estar em relevo, aqui temos outra potência de 2, 2^6, ou seja o código Braille consegue representar até 64 símbolos.
Samuel Morse não inventou apenas o código Morse, na sua época não existia nada que possibilitasse o envio de mensagens a distância sem um cavalo, um pombo-correio, sinal de fumaça ou um sistema de semáforos entre torres. Tudo mudou com a invenção do telégrafo, Morse utilizou magnetismo pra enviar corrente por um fio de um lugar ao outro, o conceito básico é transmitir corrente pelo fio quando o circuito é fechado, o que era feito por meio de uma alavanca do télegrafo, quando o sinal chega do outro lado, um mecanismo é ativado para imprimir alguma coisa, esse mecanismo pode ser uma alavanca com uma caneta presa. Você já pode imaginar o que é que era transferido com o télegrafo, sim, código Morse. Em 24 de Maio de 1844, a primeira mensagem via telégrafo foi enviada, de Washington a Baltimore, com a seguinte frase: "What hath God wrought!" significando olha só o que Deus fez.
Álgebra booleana
Um novo corpo de conhecimento evoluiu em torno do estudo da representação binária, tudo iniciou com o trabalho de George Boole (1815-1864), ele inventou um novo tipo de álgebra que hoje conhecemos por álgebra booleana, ao contrário da álgebra convencional as letras não referem-se à números, mas sim à grupos de coisas como classes ou conjuntos. Por exemplo, L pode representar o conjunto de todos os livros, P todos os livros de programação, e E todos os livros de economia. Assim como na álgebra convencional temos os operadores de adição (+) e multiplicação (x). Só que não estamos mais lidando com números, não faz sentido multiplicarmos ou somarmos conjuntos, ao invés disso usamos esses operadores para gerar novas classes. O + é usado para unir classes, podemos dizer que P+E representa o conjunto de todos os livros de programação e economia. O x por outro lado é a interesecção, é usado para obter tudo o que está em duas classes, nesse caso PxE retornaria um conjunto vazio, pois as classes não possuem nenhum livro em comum. Na álgebra booleana temos o operador de negação, aplicando esse operador ¬ em L temos todas as coisas exceto os livros, podemos substituir essa notação por 1-L, 1 em álgebra booleana representa o conjunto universo, outro exemplo pra deixar mais claro como esse operador funciona é L + (1 - L) = 1, ou seja, o conjunto de todos os livros unidos com o conjunto de todas as coisas que não são livros retorna o conjunto universo.
Podemos também montar expressões, vamos montrar uma muito simples pra acender as luzes da árvore de Natal do canal Vida em 8 Bits, as luzes (L) devem acender se:
- For Noite de Natal (N) E a árvore estiver montada (A)
- ou o Papai Noel chegou
- ou a criança pediu (C) E ainda não é de madrugada (NOT M)
Pra representar esse sistema podemos utilizar a expressão:
L = (N x A) + P + (C x (1 - M))
Provavelmente você está confuso agora, mas pra simplificar podemos pensar nesses operadores da seguinte forma:
- +: a união pode significar um OR
- x: a intersecção um AND
- 1 -: o universo menos algo pode significar um NOT
Agora podemos re-escrever a expressão, e aí fica muito mais claro o que está acontecendo:
L = (N AND A) OR P OR (C AND (NOT M))
As luzes vão acender se é noite de Natal E a Árvore está montada OU o Papai Noel chegou OU a Criança pediu E não é de madrugada
Por fim precisamos ser capazes de testar essa expressão, pra isso podemos substituir cada letra por 0s e 1s indicando se a condição daquela letra é satisfeita ou não. Vamos considerar que é noite de Natal e a nossa árvore está montada, mas o papai noel ainda não chegou e a criança está dormindo porque afinal já é de madrugada.
L = (1 AND 1) OR 0 OR (0 AND (NOT 1))
Podemos pensar nos valores 0s e 1s como falso e verdadeiro. Uma expressão AND retorna verdadeiro apenas se ambas as condições são verdadeiras:
| AND | 0 | 1 |
|---|---|---|
| 0 | 0 | 0 |
| 1 | 0 | 1 |
O OR retorna verdadeiro se ao menos uma das condições for verdadeira:
| OR | 0 | 1 |
|---|---|---|
| 0 | 0 | 1 |
| 1 | 1 | 1 |
O NOT simplesmente inverte o valor da condição:
| X | NOT X |
|---|---|
| 0 | 1 |
| 1 | 0 |
Com isso conseguimos resolver a nossa expressão e descobrir se as luzes da árvore vão ou não acender:
L = 1 OR 0 OR (0 AND 0)
L = 1 OR 0 OR 0
L = 1
E sim, as luzes vão acender pois é noite de natal e a árvore está montada, condições suficientes para acender as luzes de acordo com a expressão.
Da lógica aos circuitos
George Boole não imaginou que no século seguinte seu sistema algébrico seria a base para um enorme salto tecnológico. Claude Elwood Shannon publicou em 1938 sua tese de mestrado pelo M.I.T entitulada "A Symbolic Analysis of Relay and Switching Circuits" na qual apresentou como os relés poderiam ser utilizados para executar operações booleanas.
Um relé consiste de um switch que pode ser fechado pra gerar corrente em uma bobina, acima dessa bobina existem dois pontos de contato, o de baixo é o normalmente aberto pois só terá corrente se o switch for fechado criando um campo magnético em torno da bobina que irá atrair a alavanca metálica para fechar o contato de baixo.
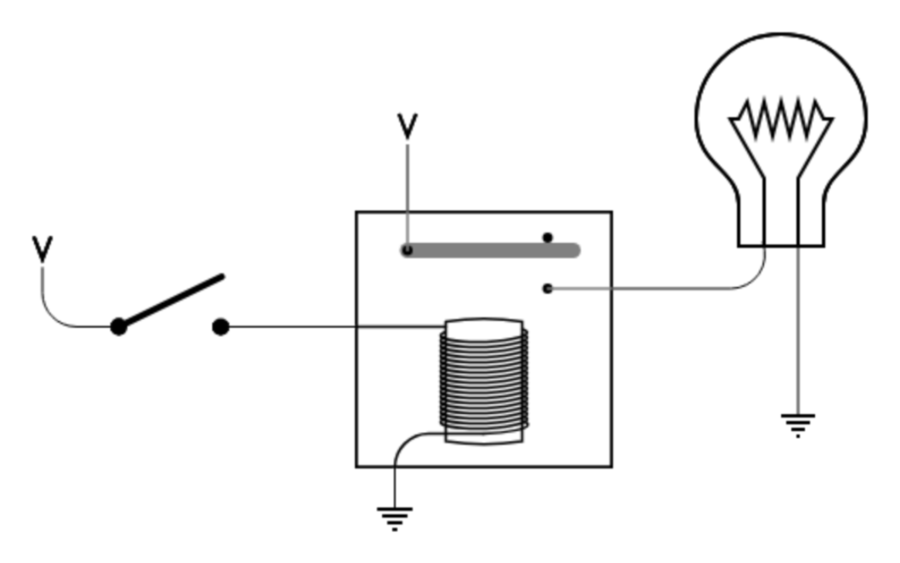
Figura 1: Um relé controlando uma lâmpada
Shannon demonstrou que dois relés conectados em série podem executar a operação AND, pois apenas fechando o circuito de ambos os relés gerará corrente na saída. A operação OR pode ser executada conectando os dois relés em paralelo, agora basta fechar o circuito de apenas um dos relés pra obtermos corrente na saída. Pra executar a operação NOT precisamos inverter a saída, isso pode ser resolvido conectando a saída ao ponto de contato normalmente fechado, enquanto o switch estiver aberto a saída terá corrente passando, e quando o switch for fechado, a bobina irá atrair a alavanca e a saída não receberá mais corrente.
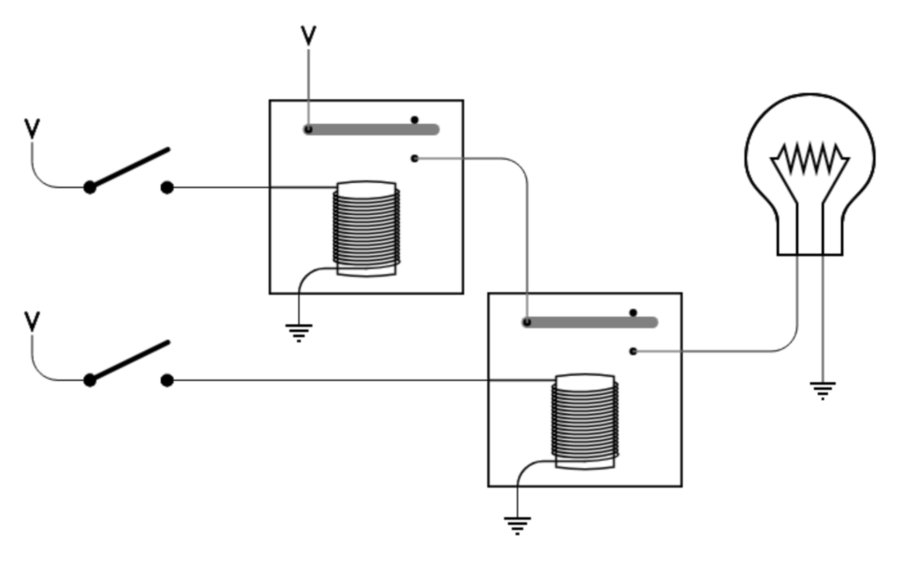
Figura 2: AND: dois relés em série
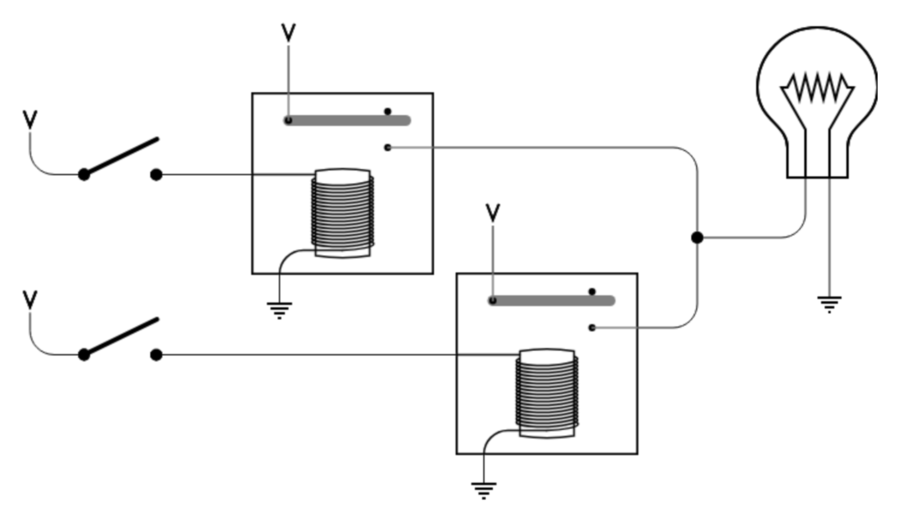
Figura 3: OR: dois relés em paralelo
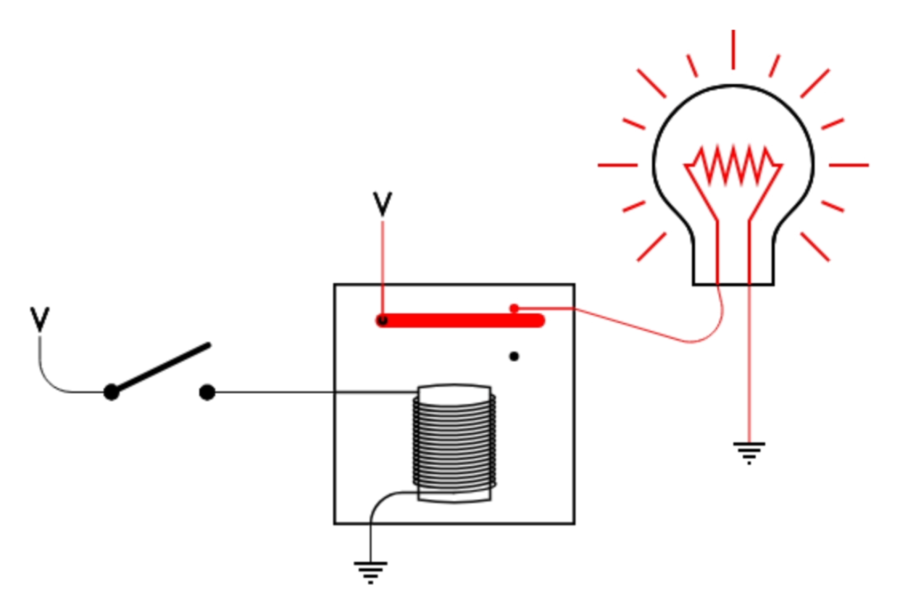
Figura 4: NOT
Essa união da matemática com a eletricidade foi o nascimento das portas lógicas que são a base dos circuitos eletrônicos utilizados nos computadores modernos.
Dos teares aos primeiros computadores
A história da computação pode começar a ser contada pela máquina analítica de Charles Babbage (1791-1871), que foi tirada do papel apenas após a sua morte. Era programável por meio de cartões perfurados, conceito esse que Babbage tirou da máquina de tear de Joseph-Marie Jacquard, que cansado da tediosa tarefa de ter de mudar os novelos a toda hora para poder gerar os desenhos coloridos solicitados pelos clientes, Jacquard criou uma máquina de tear totalmente programável por meio de cartões perfurados, um buraco no cartão indicava que um fio deveria ser levantado, enquanto que a ausência do buraco indicava que o fio permaneceria abaixado.
Os cartões perfurados foram usados novamente por Herman Hollerith para calcular em tempo recorde os dados do censo dos Estados Unidos de 1890, Hollerith viria mais tarde a fundar a Tabulating Machine Company especializada em equipamentos de tabulação, que em 1920 foi transformada na International Business Machines Corporation, a IBM.
Durante a Segunda Guerra Mundial, da cooperação entre Howard Aiken, um estudante da Universidade de Harvard, e a IBM surgiu o Mark I. Howard projetou a máquina pra lhe auxiliar na execução de muitos cálculos repetitivos que precisava fazer, e a IBM construiu. A máquina foi utilizada pra resolver problemas matemáticos relacionados com a guerra. Grace Hopper que após a guerra recebeu a tarefa de escrever o manual do Mark I, foi a responsável por popularizar o termo bug na área da computação, depois de remover um inseto que estava bloqueando um relé e uma fita de papel ela disse que havia "debugado" a máquina e colou o inseto no diário de bordo com a nota: "Primeiro caso real de bug encontrado". Válvulas não eram muito confiávies, podiam queimar do nada, além disso eram caras, precisavam de muita eletricidade e geravam muito calor. Então o Mark I foi construído com muitas peças mecânicas como relés e switches, relés por serem mecânicos são ordens de grandeza mais lentos que válvulas, mas naquele momento isso não era um grande problema, os programas eram lidos a partir de fitas de papel perfurado e era isso que definia a velocidade da máquina, não importando o quão rápido os relés ou as válvulas fossem.
Máquinas como o Mark I são máquinas eletromecânicas, dentre as primeiras máquinas verdadeiramente eletrônicas estão o Colossus e o ENIAC, essas sim funcionavam por meio de válvulas, pense em algo parecido com lâmpadas incandescentes, operadores precisavam configurar a máquina pra executar cada cálculo e podiam verificar o resultado pelas válvulas do painel. O ENIAC pesava cerca de 30 toneladas e usava impressionantes 18 mil válvulas, foi extremamente útil na Segunda Guerra pro cálculo de tabelas balísticas.
Uma válvula ou uma lâmpada consegue representar dois estados, desligado e ligado, ou 0 e 1. Com um conjunto de lâmpadas já conseguimos representar números, pra entender isso na prática vamos pegar um conjunto de três lâmpadas. Com todas as lâmpadas apagadas temos o 0, ligando a primeira lâmpada temos o 1, até aqui é intuitivo, mas e como é que vamos representar o 2? Bem, poderíamos simplesmente ligar a segunda lâmpada, e depois a terceira para representar o 3, e continuar adicionando mais e mais lâmpadas para representar mais números. Esse foi de fato o sistema utilizado pelo ENIAC, cada lâmpada representava os dígitos de 0 a 9. Mas podemos melhorar isso com o sistema binário, para representar o 2, ao invés de apenas ligar a segunda lâmpada, também desligamos a primeira, agora ligamos novamente a primeira e aí sim temos o 3, desligamos a primeira e a segunda e ligamos a terceira pra obter o número 4, ligamos a primeira e temos o 5, desligamos a primeira e ligamos a segunda e temos o 6, e por fim com todas as lâmpadas ligadas temos o número 7. Uma baita melhora, mantemos o mesmo número de lâmpadas e coseguimos representar mais do que o dobro de informação.
John von Neumann (1903-1957), um dos gênios da computação ajudou a projetar o sucessor do ENIAC, o EDVAC (Electronic Discrete Variable Automatic Computer). Os projetistas decidiram utilizar o sistema binário pra representação dos dados, além disso foi definido que a máquina teria uma região de memória para armazenar tanto o código do programa quanto os dados, completamente diferente do ENIAC onde operadores tinham que configurar a máquina via switches e cabos para cada programa. As contribuições de von Neumann foram tão importantes que a arquiteura dos computadores modernos é chamada não por acaso de arquitetura von-Neumann.
Não esqueci de Alan Turing, o conceito de computador como entendemos hoje foi criado por ele com a máquina universal de Turing, mas isso é assunto pra um futuro vídeo dedicado exclusivamente à esse assunto. Turing também foi uma peça fundamental do time de criptoanalistas no Bletchley Park, o principal centro de decifração de códigos dos Aliados durante a Segunda Guerra, lá foi construída a máquina Bombe que foi capaz de decodificar em tempo útil mensagens da máquina Enigma.
Bits isolados não conseguem fazer muita coisa, representam um sim/não, verdadeiro/falso, ligado/desligado, mas aumentando a quantidade de bits conseguimos coisas interessantes, com apenas 2 bits já conseguimos representar 4 combinações diferentes: 00, 01, 10, 11.
Esse é um bom momento pra usarmos 2 bits pra ajudar o canal:
- 01 significa que você deu um joinha aqui no vídeo
- 10 significa que você deu o joinha e também se inscreveu no canal
- 11 significa que além disso você ativou o sino das notificações
- 00 não interessa
Bora lá ligar esses 2 bits.
O transistor
A computação e a eletrônica evoluiram muito desde então, essas máquinas ocupavam andares inteiros, geravam um calor absurdo e consumiam muita energia, hoje temos computadores extremamente poderosos que cabem no nosso bolso, o que possibilitou esse grande avanço da computação foi uma invenção gestada no Bell Labs. De lá surgiram inúmeras invenções, desde o laser à linguagem de programação C, mas nada se compara a descoberta do transistor. Em 16 de dezembro de 1947, os físicos John Bardeen (1908-1991) e Walter Brattain (1902-1987) trabalhando para William Shockley (1910-1989) descobriram um novo tipo de amplificador sem a necessidade de vácuo usando germânio e uma tira de folha de ouro. Semicondutores como o Germânio possuem uma estrutura cristalina e praticamente não conduzem energia em condições normais, a grande sacada é que podem ser dopados adicionando impurezas pra conduzir mais ou menos energia, a partir disso os físicos criaram uma estrutura pra permitir controlar a saída do sinal via aplicação de uma voltagem de energia na base do componente. Comparados com válvulas, transistores são muito menores (mesmo nas primeiras versões), demandam menos energia, geram menos calor e têm uma durabilidade muito maior. Em 1956, Shockley deixou a Bell Labs para criar a Shockley Semiconductor Laboratories em Palo Alto, California, desde então muitas empresas de semicondutores e de tecnologia em geral se estabeleceram lá, área essa conhecida hoje como Vale do Sílicio. Atualmente processadores têm bilhões de transistores, o processo de construção é extremamente complexo, mas no nível mais baixo, assim como as válvulas das antigas máquinas, transistores podem assumir dois estados: 0 ou 1.
E agora deve estar claro porque a representação binária é tão importante em computadores, permite unir aritmética, lógica e eletricidade: 0s ou 1s podem ser transmitidos por fios, válvulas ou transistores, com álgebra booleana podemos criar expressões lógicas para resolver problemas específicos, a teoria da álgebra booleana pode ser replicada fisicamente por meio de portas lógicas dentro de circuitos integrados presentes nos computadores modernos.
Código de barras
Códigos binários são eficientes para representar informação e não apenas dentro de computadores. Já falamos do código Morse e do Braille, mas agora vamos ver alguns exemplos mais próximos dos 0s e 1s.
Um código binário muito presente no nosso dia-a-dia é o código de barras, olhamos pra eles como um conjunto de barras longas com alguns números impressos na parte inferior, mas podemos pensar como uma sequência de bits. Os leitores de códigos de barras não visualizam as barras completas e muito menos os números, o que interessa pra detectar o valor do código é apenas uma pequena tira horizontal, onde é preto temos 1s, onde é branco temos 0s. O código correpondente é impresso apenas pra auxiliar os atendentes nos casos em que tenha sido danificado e não possa ser lido, aí pode ser informado manualmente.
Existem vários formatos de códigos de barras, o UPC utilizado nos Estados Unidos possui 30 barras, cada uma pode possuir até 4 larguras, a menor representando 1 bit até 4 bits para a maior. Para evitar ter que padronizar larguras exatas para as barras, o código possui o padrão 101 no começo, assim os leitores conseguem se orientar e saber qual é o tamanho base das barras utilizado naquele código, esse mesmo padrão é repetido no final do código pra permitir ler de trás pra frente sem problemas. Entre esses 2 códigos fixos existem 12 grupos de 7 bits separados por um padrão fixo de 5 bits codificados como 01010, essa é uma forma de checagem de erros, se o leitor não identificar esse padrão significa que houve algum erro na leitura. Os 12 grupos de 7 bits representam os números que vemos impressos no código de barras, mas não é uma conversão direta de binário pra decimal, existe uma tabela de mapeamento pra auxiliar na checagem de erros. Todos os códigos possíveis para os grupos da esquerda começam com um 0 e terminam com um 1, se o leitor encontrar algum código nos grupos da esquerda começando com 1 ou terminando com 0, significa que houve algum erro na leitura ou que o código foi adulterado, para os códigos da direita a lógica é a inversa, todos os códigos começam com um 1 e terminam com um 0. Esse não é o único mecanismo pra checagem de erros, todos os códigos da esquerda possuem um número ímpar de 1s e os da direita um número par de 1s, essa característica também é importante pra leitura do código invertido, se o leitor encontrar primeiro códigos com um número par de 1s sabe que tem que começar utilizando os códigos do grupo da direita.
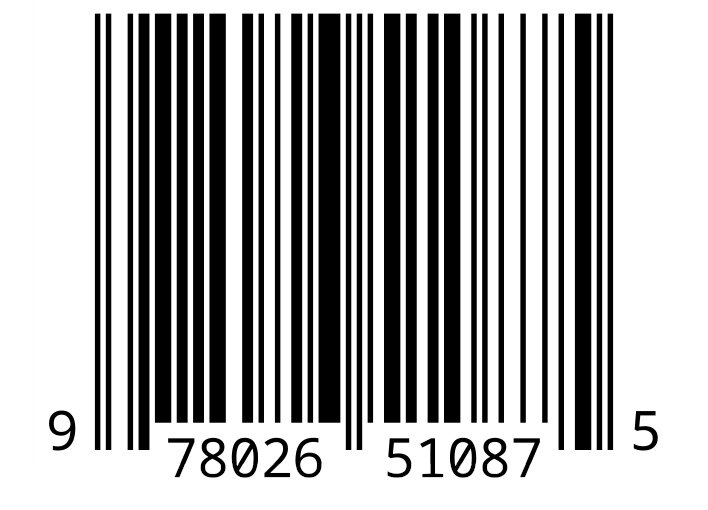
Figura 5: Código de barras gerado para o exemplo
Pra ver na prática gerei um código de barras qualquer, comecei inserindo o binário fixo 101, a seguir os grupos dos 6 dígitos da esquerda, depois o padrão fixo do meio 01010, aí os grupos dos 6 dígitos da direita e por fim novamente o padrão 101. Podemos ver todos os 1s onde estão as barras pretas e todos os 0s onde é branco, além disso convertendo os binários a partir da tabela de códigos conseguimos chegar no mesmo código impresso na parte inferior:
9 780262 510875

101
0001011
0111011 0110111 0001101 0010011 0101111 0010011
01010
1001110 1100110 1110010 1001000 1000100 1001110
QR Code
Pra codificar mais do que apenas alguns números foi criado o QRCode. É um código de 2 dimensões composto por módulos que armazenam 1 bit cada. Dentre as várias versões a maior é a 40, possui 177 módulos de altura e de largura, poderia armazenar até 31.329 bits, mas uma grande parte disso é destinada pra correção de erros. Os 4 quadrados foram projetados para auxiliar na leitura do código, os 3 maiores são padrões de localização separados por uma zona com quadrados brancos para facilitar a detecção, o quadrado menor é um padrão utilizado pra alinhamento em caso de distorções durante a leitura. Pra descobrir o número de células no QRCode são utilizadas estas sequências horizontal e vertical de quadrados pretos e brancos alternados. Esses 15 bits próximos aos quadrados maiores definem dados sobre o formato do código, isso pode ser utilizado pelos geradores de QRCode pra definir coisas como o nível de correção de erro desejado.
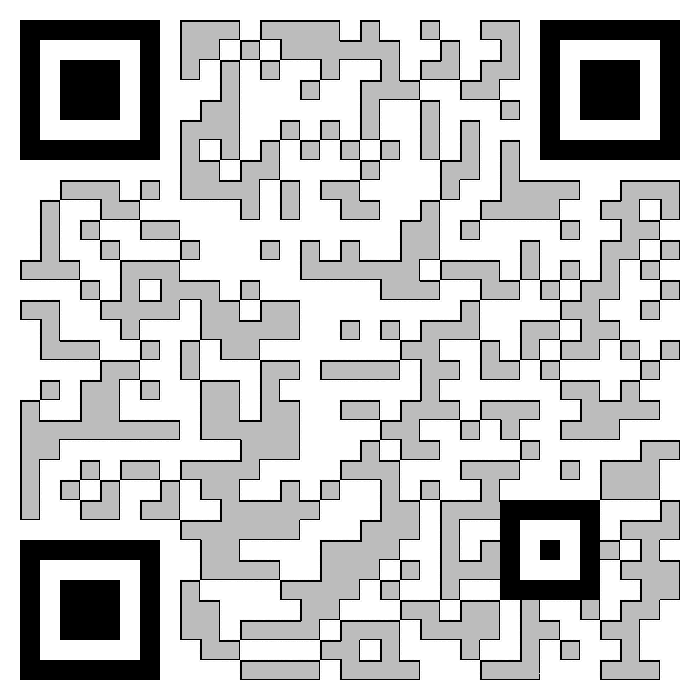
Figura 6: O QR Code do blog Vida em 8 Bits
A leitura dos dados começa no canto inferior direito, são 4 bits que definem o tipo de dado codificado:
| Type | Meaning |
|---|---|
| 0001 | Numbers only |
| 0010 | Uppercase letters and numbers |
| 0100 | Text encoded as 8-bits values |
| 1000 | Japanese kanji |
Por exemplo, pra codificar qualquer link podemos utilizar o tipo de dado 0100 para codificação de texto.
Vamos codificar o link do blog Vida em 8 Bits: https://vidaem8bits.com
Depois do tipo de dados temos 8 bits que especificam a quantidade de caracteres codificados no QRCode.
O link tem 23 caracteres, então o binário tem que ser 0001 0111. Mas pera lá, estes não são os bits que estamos vendo no QR Code, isso se dá porque uma máscara é aplicada com o objetivo de facilitar a leitura. Existem 7 tipos de máscaras, todas as 7 são aplicadas, e aquela que gerar um resultado melhor é escolhida. Os 3 bits que indicam qual máscara foi utilizada na geração são codificados nos bits que indicam o formato do QRCode. Com isso, o leitor consegue remover a máscara durante a leitura aplicando um XOR entre os bits da máscara e os bits do QRCode.
A seguir cada caractere é codificado como um valor de 8 bits utilizando a representação binária da tabela ASCII, mas antes de falar sobre a tabela ASCII precisamos abrir uma tangente pra entender como computadores interpretam bits.
Bytes e hexadecimal
Bits não são manipulados isoladamente, a menor unidade de memória é um bloco de 8 bits, ao que chamamos de 1 byte, termo esse originado dentro da IBM. Um byte (00000000 - 11111111) consegue representar até 256 valores, de 0 a 255, mas a manipulação de bytes na memória é feita a partir de um tamanho que em Ciência da Computação chamamos de word size, os computadores pessoais da década de 70 e início da década de 80 eram de 8 bits, aí evoluímos pra 16 bits, 32 bits, e hoje temos computadores de 64 bits. Isso significa que no nível do hardware temos registradores capazes de manipular até 8 bytes em uma única instrução.
Em muitos programas precisamos definir padrões de bits, só que a representação binária é muito extensa e ficar convertendo pra decimal toda hora é inconveniente pois a conversão como vimos não é muito direta. Pra resolver esse problema podemos recorrer a outra base numérica que facilite a conversão e reduza o número de caracteres, por exemplo, utilizando a base octal conseguimos reduzir cada grupo de três bits para um único dígito em octal:
1 101 011 011 101 101
1 5    3    3    5    5
Mas tem um grande problema aqui, 1 byte tem 8 bits, essa conversão em grupos de 3 bits gera valores diferentes dependendo de como for aplicada, se ao invés de aplicar aos 2 bytes aplicarmos byte a byte, os valores gerados serão completamente diferentes:
11 010 110,11 101 101
3   2   6     3  5    5
Pra resolver esse problema temos a representação em hexadecimal que usa base 16, e pra isso utiliza os dígitos de 0 a 9, e as letras de A a F:
| Hexa | Binário | Hexa | Binário |
|---|---|---|---|
| 0 | 0000 | 8 | 1000 |
| 1 | 0001 | 9 | 1001 |
| 2 | 0010 | A | 1010 |
| 3 | 0011 | B | 1011 |
| 4 | 0100 | C | 1100 |
| 5 | 0101 | D | 1101 |
| 6 | 0110 | E | 1110 |
| 7 | 0111 | F | 1111 |
Com isso, como um byte tem 8 bits e cada caractere hexadecimal é representado com 4 bits fica muito direto converter um número binário em hexadecimal:
10 1111 0011 1010 1000
2   F     3     A      8
Iniciamos a conversão da direita pra esquerda, primeiro temos 8, depois 8 + 2, 10 que em hexa é o A, depois o 3, aqui temos todos os bits ligados, então é fácil de ver que é o F, e por fim temos apenas 2 dígitos, isso acontece porque esse binário não é múltiplo de 4, então faltam dígitos pro último caractere hexadecimal, aí simplesmente adicionamos 0s à esquerda, e temos o 2.
Texto e a tabela ASCII
Podemos pensar na representação de informação como bits + contexto, no exemplo das lâmpadas cada lâmpada representa um bit e naquele contexto interpretamos os bits para a representação de números. Mas sabemos que computadores podem representar outros tipos de dados como textos por exemplo. Se computadores internamente possuem apenas 0s e 1s, cada letra do alfabeto pode ser mapeada para uma representação binária, e é exatamente isso que a tabela ASCII faz, é uma representação de 7 bits que vai de 00h até 7Fh em hexadecimal, permite representar até 128 valores, o suficiente para mapear letras da língua inglesa, dígitos, pontuação e alguns códigos de controle. As letras maiúsculas e minúsculas possuem uma diferença de 20h em hexa entre cada uma, isso significa que pra converter de lower case pra upper case basta diminuir 20h em hexa de cada caractere. A ordenação alfabética é super simples pois todas as letras seguem uma sequência sem qualquer outro tipo de caractere entre elas, por exemplo no antigo EBCDIC criado pela IBM pra utilizar nos cartões perfurados do IBM System/360 havia gaps entre as letras, aí ordenar utilizando apenas o valor do código de cada caractere geraria resultados estranhos.
Muitos dos códigos de controle não fazem mais sentido pois foram criados na época dos teletipos, dois deles geraram muita confusão, o Carriage Return e o Line Feed. Pra pular de linha nos teletipos era preciso retornar o carro pro começo da linha (Carriage Return) - o carro é aquela parte da máquina que se movimenta conforme a digitação - só que continuar digitando após esse comando ia escrever tudo em cima da última linha que recém havia sido escrita, então além disso era preciso subir o papel (Line Feed), aí sim, com esses dois comandos efetivamente uma linha era pulada. Acontece que com o advento dos computadores os componentes mecânicos sumiram e foi preciso definir como representar uma nova linha, cada sistema operacional foi por um caminho diferente, Windows decidiu manter o que era usado nos teletipos, CR seguido de LF, Linux e Apple decidiram simplificar usando apenas 1 comando, Linux optou por LF e Apple por CR. Aí a confusão tava feita, arquivos criados em um sistema operacional usando a codificação ASCII eram lidos com erros de formatação em outros sistemas operacionais. Com isso todos os programas que lidam com texto que se prezam já sabem que precisam identificar o padrão que foi utilizado pra poder interpretar os dados corretamente.
Vamos ver isso na prática, vou escrever Hello World separado por uma quebra de linha em um arquivo texto qualquer:
  echo "Hello\nWorld" > hello.txt
  xxd hello.txt
O programa xxd permite inspecionar os bytes de qualquer arquivo, já sabemos que cada caractere em um arquivo texto é representado por um byte, podemos reconstruir o Hello World consultando byte por byte o valor correspondente na tabela ASCII:
| 48 | 65 | 6c | 6c | 6f |
|---|---|---|---|---|
| H | e | l | l | o |
a seguir onde no texto temos a quebra de linha encontramos o byte 0a, esse é o Line Feed porque estou usando Linux, na sequência temos os bytes restantes pra formar a palavra World:
| 57 | 6f | 72 | 6c | 64 |
|---|---|---|---|---|
| W | o | r | l | d |
e no final do arquivo novamente o byte de Line Feed.
Unicode e encodings
O ASCII foi criado pra representar textos da língua inglesa, pra suportar outras línguas começou-se definindo novos mapeamentos exclusivos para cada país. Mesmo utilizando 7 bits, a grande maioria dos sistemas já armazenava os dados utilizando 8 bits, então a primeira coisa que foi feita foi criar extensões do código ASCII, o Windows definiu inicialmente o ANSI pra representar símbolos e caracteres acentuados de línguas europeias, pra isso utilizou os códigos de A0h até FFh e posteriormente extendeu esse padrão pra utilizar os códigos restantes de 80h até 9Fh ao que chamou de Windows-1252. Na Ásia surgiram mais extensões para representar ideógrafos das suas línguas.
Nem o ASCII, nem nenhuma de suas extensões são capazes de representar texto em línguas com mais do que 256 símbolos, pra resolver esse problema em 1988 grandes empresas de computação se reuniram pra desenvolver o Unicode. Inicialmente foi definido como um código de 16 bits, e aí já apareceu o primeiro problema, big endian e little endian. Dependendo da arquitetura do computador os bytes são lidos de formas diferentes, computadores de 16 bits tem um word size de 2 bytes, isso significa que os dados na memória são lidos de 2 em 2 bytes, máquinas big endian lêem os bytes da forma natural, o byte mais significativo primeiro (por isso o big no nome), já máquinas little endian lêem primeiro o byte menos significativo. Pra ver isso na prática, vamos pegar o símbolo PI no Unicode que é representado pelos bytes: 03C0h
Uma máquina big endian lendo esses bytes vai exibir o caractere PI como esperado, mas uma máquina little endian vai interpretar como C003h, um símbolo do alfabeto Coreano. Pra resolver esse problema o Unicode define o caractere especial BOM (byte order mark) para ser colocado no início de um arquivo Unicode, para máquinas big endian, os 2 primeiros bytes no arquivo devem ser FEh e FFh, para máquinas little endian, devem ser FFh e FEh.
Pra validar isso verifiquei qual é o endian da minha máquina e a seguir criei dois arquivos escrevendo diretamente os bytes: o BOM seguido do caractere PI, um em little endian e o outro em big endian:
  lscpu | grep -i endian
  printf '\xFF\xFE\xC0\x03' > pi_le.txt
  printf '\xFE\xFF\xC0\x03' > pi_be.txt
  vscodium pi_le.txt pi_be.txt
Como esperado o arquivo little endian exibe o PI e o arquivo big endian exibe o caractere coreano, se minha máquina fosse big endian, obviamente o resultado seria o inverso.
Com o Unicode é possível representar alfabetos maiores como Grego, Russo, Chinês e Japonês e até mesmo representar emojis. Em 2001, o comitê técnico do Unicode rejeitou uma proposta para incluir a língua Klingon de Star Trek, o Jovem Sheldon não ficou nada contente com isso. Pra suportar tudo isso utiliza-se 32 bits, a primeira vista isso obriga todo caractere utilizar 4 bytes, o que seria um enorme desperdício para textos que não precisam de toda essa flexibilidade. Pra resolver isso o Unicode define um conjunto de encondings, são basicamente regras para a representação dos bytes, o encoding base usa de fato 32 bits, mas outros encodings são permitidos, que definem caracteres comuns utilizando apenas 1 ou 2 bytes e caracteres menos comuns utilizando mais. O UTF-8 por exemplo, codifica todos os caracteres da tabela ASCII utilizando a codificação original, garantindo que sequências de bytes criadas com base na tabela ASCII possam ser lidas corretamente com o UTF-8.
Se você já trabalha com programação certamente já esbarrou em algum erro de encoding, pra simular isso vou escrever o byte 83 em um arquivo qualquer:
  printf '\x83' > file.txt
  vscodium file.txt
No Unicode esse byte é um código de controle, então ao abrir com UTF-8 vai gerar o infame erro de encoding, mas esse mesmo byte no formato Windows-1252 que falamos anteriormente é o símbolo da moeda Euro, por isso é muito importante definir corretamente o encoding no qual o dado foi gerado pra poder interpretar os bytes corretamente.
Imagens e vídeos
Mas nem só de texto vive um computador, pra começar a falar de imagens e vídeos temos que dar um passo pra trás pra entender como as cores são representadas no computador. A ideia é basicamente a mesma do texto, números armazenados em bytes e interpretados de acordo com algumas regras. Nesse caso são 3 bytes, um pra cada cor do sistema RGB: Red, Green e Blue. Cada pixel na tela emite luz nessas cores primárias que misturadas permitem a criação de inúmeras outras cores, um byte pra cada cor significa que podemos definir 256 intensidades para cada cor, 256^3 é o número de cores que podem ser criadas com todas as combinações, ou 16.777.216 cores diferentes. Por exemplo R=72, G=73 e B=33 produz esse amarelo. Isso significa que sua câmera de 10 MP gera 10 milhões de pixels, cada pixel tendo 3 bytes, temos 30 milhões de bytes ou 30 megabytes. Mas na prática o arquivo gerado é muito menor graças a algoritmos de compressão. Dois tipos muito comuns de imagens são JPEG e PNG. JPEG usa algoritmos de compressão lossy, esses algoritmos exploram a forma como o olho humano percebe imagens descartando informação que não afeta nossa percepção da qualidade da imagem, isso possibilita grandes reduções nos tamanhos dos arquivos. PNG por outro lado usa algoritmos de compressão lossless, esses algoritmos não jogam fora nenhum dado, apenas removem redundâncias, a desvantagem é que a redução no tamanho dos arquivos é muito menor, mas garante a manutenção da qualidade da imagem original.
Se já trabalha com HTML, sabe que as cores são definidas com uma notação hexadecimal, bem, essa notação deriva do sistema RGB, os primeiros 2 dígitos representam o byte R, a seguir o G e o B.
Com o conceito de imagens compreendido, vídeos vêm de graça, um vídeo consiste de múltiplas imagens, basta ter uma quantidade grande o suficiente que o nosso olho não consiga detectar que são imagens separadas. Pra uma tela Full HD 1080p, isso significa que temos 1920 pixels na horizontal e 1080 na vertical, tudo isso vezes 3 bytes e temos mais de 6 milhões de bytes sendo processados e exibidos pra cada imagem de um vídeo, outra medida que entra aqui é o famoso FPS, 30 é um valor comum para vídeos e 60 é o utilizado pra esportes e games, agora pega aqueles mais de 6 milhões de bytes e multiplica por esse valor, essa é a quantidade de bytes processados por segundo pra você assistir seu vídeo ou jogar seu jogo.
Aprender a programar de verdade
Se você tava pensando que esse vídeo era só mais um sobre história da computação, você foi enganado com sucesso. Esse foi apenas o primeiro de uma série de vídeos pra te ensinar a programar. Eu poderia começar te ensinando programação com o clássico Hello World, você ia decorar algumas instruções, ver um programa de verdade fazendo alguma coisa, mas você não ia aprender a programar, no máximo ia aprender uma receita de bolo. Poderiamos continuar, de exemplo em exemplo, criando programas mais complexos, mas dificilmente você iria aprender a programar, você iria na melhor das hipóteses decorar um punhado de instruções em uma linguagem específica, usadas de formas específicas para resolver problemas específicos. Cada problema novo que te aparecer na frente e você vai estar lá completamente perdido. Para todo problema, vai pensar sempre de um jeito que se encaixe naquelas fórmulas prontas que você já viu.
Pra aprender a programar, não basta copiar e colar alguns comandos e ver uma saída na tela, é preciso entender como o computador entende esses comandos e como aquela saída é gerada na tela pra você. Sabemos que computadores nos mostram informações nos mais variados formatos: texto, imagem, som e vídeo. Hoje descemos ao nível mais baixo, entendemos que computadores são compostos de bilhões de transistores, e que é possível representar informação com isso e manipular essa informação para resolver problemas. Responder essas perguntas é o único jeito de aprender a programar de verdade. No próximo vídeo vamos começar a programar de fato com a linguagem C, te vejo lá!